 Global
 United States
 Japan




Table of Contents
過去10年の大半において、「AIハードウェア」とはスケーラブルなGPU、データセンターの拡張、そしてコンテキストウィンドウの拡大を意味していました。インテリジェンスがブラウザのタブ内に閉じ閉じている限り、そのモデルは十分に機能していました。しかし、エージェントが自律的にドアを開け、ベルトコンベアから非定形ワークをピックアップし、不整地での転倒を即座に回避しなければならない局面を迎えたことで、そのアプローチは限界に達しています。
これこそが、現在業界でフィジカルAI(Physical AI)と呼ばれているパラダイムシフトです。フィジカルAIとは、動的かつ非構造化された現実世界において、即座に物理的影響を及ぼす環境下で認知・推論・動作(Actuation)を行うAIシステムを指します。これを実現するには、厳しいSWaP-C(小型・軽量・低電力・低コスト)制約を満たし、ネットワーク瞬断時にも完全オンデバイスでリアルタイム処理を実行できるハードウェアが不可欠です。
ヒューマノイドロボットは、ハンドアセンブリが保持するワークのスリップ判定に、クラウドインファレンスとの往復400msものレイテンシを許容できません。倉庫内を自律走行するAGV/AMRのローカル制御ループにおいても、決定論的タイトなサイクル制御の欠落は許されません。フィジカルAIの世界において、レイテンシは単なるUX指標ではなく、決定的な機能安全仕様(Functional Safety Spec)そのものです。
本稿では、このシフトの背後にあるハードウェアの技術的実態に迫ります。現代のロボティクス・コンピューティング・プラットフォームに求められる実装、LLM開発における「GPU計算資源のスケールアウト」という手法が通用しない技術的背景、そして単なるチップ設計にとどまらず、これらを統合・実装・製造(DFM)できる企業が、フィジカルAIにおける最大のボトルネックであり、最大の参入障壁(Moat)となる理由を解説します。
Physical AIがデータセンターの従来型アプローチを覆す理由
クラウドAIシステムは、基本的に**「1ドルあたりのスループット」**という単一の指標を中心に最適化されています。一方、ロボットは、より複雑で相互に関連する複数の制約条件を同時に満たす必要があります。
- リアルタイム性と決定論的動作(Deterministic Control)
アクチュエータのオーバーシュートを抑え、適正な把握力を維持し、姿勢制御を安定させるフィードバック制御ループは、サブミリ秒からミリ秒オーダーの確定的な周期で完結する必要があります。ジッター(周期ゆらぎ)の発生はフェールセーフ違反に直結するため、バッチ処理のスループット最大化を意図した汎用GPUアーキテクチャ単体では、このハードリアルタイム層に対応しきれません。 - 厳格なTDP・熱設計枠におけるマルチモーダル・センサフュージョン
カメラ、ToF/LiDAR、IMU、6軸力覚センサ、さらには高密度触覚アレイからの非同期ストリームをリアルタイムに統合し、一貫した世界モデル(World Model)を構築する必要があります。これを、ファンレスやペルチェ素子・液冷などの制約があるバッテリー駆動のエッジデバイス上で実現しなければなりません。 - ヘテロジニアス・コンピューティングのワンボード統合
ロボティクスの統合処理部(Brain Unit)には、システム統括および機能安全を担うHost CPU、推論・認識処理を加速するGPU/NPU、そして確定的なセンサI/O制御やインターロック回路を実装するFPGA/Adaptive SoCが必要です。これら極めて異なるプロセッサ・アーキテクチャを、限られた基板面積と熱量枠(Thermal Envelope)の中に高密度実装(SiP/SoM等)する必要があります。 - Sim-to-Realギャップの極小化
物理シミュレータ上で学習した強化学習(RL)モデルは、摩擦係数、接触力学、センサノイズなどの近似誤差により、実機展開時に性能が乖離(Degrade)します。このギャップを埋めるには、事前学習モデルの精度だけでなく、環境の変化にリアルタイムで即応・補正(In-situ Adaptation)を行えるオンデバイスの余剰計算リソース(Compute Margin)が不可欠です。 - ベンダーロックインのリスク回避
長期的な製品ライフサイクルを持つロボティクスOEMは、単一の垂直統合型プロプライエタリ・スタックに依存することを警戒しています。そのため、異種シリコン世代間でのポータビリティを担保する、オープンなソフトウェアエコシステム(ROS 2、OpenVX、TVM等)へのシフトが急務となっています。
これらの課題は、データセンター向けGPUを単純にダウンサイジングするだけでは解決できません。CPU、GPU/NPU、およびアダプティブ・ロジック(FPGA)を同一ダイまたは同一モジュール上でコ・デザイン(HW/SW協調設計)した専用のプロセッサ・アーキテクチャが求められます。
現代のロボット・ブレインを構成する3層のハードウェア/ソフトウェア・スタック
抽象化レベルを整理すると、先進的なフィジカルAIプラットフォームの多くは、以下の3層アーキテクチャへと収束しています。
マーケティング上の表現を取り除いて考えると、Physical AIプラットフォームの多くは、概ね共通したアーキテクチャに収束しています。
1. センシング&ハードリアルタイム制御・安全レイヤー
上位のAIタックの動作状態から独立して機能する、確定的な低レイテンシ・ロジック(主にFPGA/Adaptive SoC実装)です。多軸センサフュージョン、ハードウェアベースの機能安全インターロック、および超高速なハードリアルタイム制御を担保します。
2. 認知・推論レイヤー(Perception & Reasoning Layer)
Host CPUとGPU/NPUコンピュートで構成され、コンピュータビジョン、言語処理、および高度な意思決定モデルを実行します。物体認識、3D空間把握、ならびに生のセンサ入力(RGB-D等)から直接モータ制御コマンド(関節角・トルク)をエンドツーエンドで出力するVLA(Vision-Language-Action)モデルのインファレンスを包含します。
3. システム&マニュファクチャリング・レイヤー
ハードウェアの物理的・物理層の実装領域です。高周波・高密度多層PCB設計、熱解析・放熱設計、耐振・堅牢化(Ruggedization)、EMC/EMI適合性、MIPI/GMSLなどの高速カメラ・センサ統合インターフェース、そしてリファレンス設計を数台のプロトタイプから四半期数千台規模の安定生産(Yield Control)へスケールさせるためのサプライチェーンおよび製造品質管理を含みます。
レイヤー1とレイヤー2は多くの注目を集めています。しかし、実際に多くのロボティクス・プログラムが行き詰まるのはレイヤー3です。そして、本稿が本当に焦点を当てているのも、このレイヤーです。
注目すべきポイント:Physical AIを支えるエンジニアリングと製造の橋渡し
リファレンスボードは製品ではありません。「評価キット(Dev Kit)上でチップが動作する」段階から、「万単位のロボットフリートを現場に安定出荷する」段階へのアプローチには、泥臭くも高度な泥臭いハードウェア・エンジニアリングが必須となります。
極小シャーシ内でCPU、GPU/NPU、Adaptive SoCの熱暴走を防ぐ高密度多層基板のサーマル設計、実験室ではなく実環境の環境光変動・激しい振動に対応したカメラ/センサ校正(Calibration)およびモジュール統合、EMC/EMI規格への適合、そして潜在欠陥(Silent Defect)を1点たりともミッションクリティカルな実機へ流出させない、厳密な公差管理(Tolerance Control)を備えた量産検査ラインが要求されます。
これこそが、VVDN Technologiesが確固たるポジションを築いている領域です。VVDNは単なるファブレスやチップデザイナーではなく、ヘテロジニアスな計算基盤を、フィールド導入可能で各種安全規格認証を取得できるロボティクス・ハードウェアへと昇華させる「エンジニアリングおよび製造のブリッジ(Bridge)」として機能します。
その提供価値は、レイヤー3が求めるフルスペックを網羅しています。
- エンドツーエンドのプロダクト・エンジニアリング
基板設計(PCB Layout)やファームウェア開発から、機構・構造設計、熱シミュレーションまでを包括的に提供。異種プロセッサ(CPU/GPU/NPU/Adaptive SoC)で構成される複雑なシステムを、評価環境だけでなく、実世界の振動、熱サイクル、稼働耐久性に耐えうるプロダクトへと落とし込みます。 - ビジョン&センサフュージョン・リファレンスプラットフォーム
フィジカルAIの認知レイヤーに特化し、カメラ、Depth、LiDAR、IMUの高度な統合を実現。実運用の照度変化、ノイズ、耐環境性(防塵・防水・耐振)に最適化されたプラットフォームを提供します。 - スケールに対応する製造・検証インフラ
自社保有のSMT(表面実装)ライン、基板検査(AOI/AXI)、組み立て、環境/機能検証、安全認証ラインを活用し、プロトタイプから四半期数千台規模の量産移行時における歩留まりの維持と品質バラツキの撲滅を実現します。 - 自社スマートファクトリーにおけるフィジカルAIのドッグフーディング
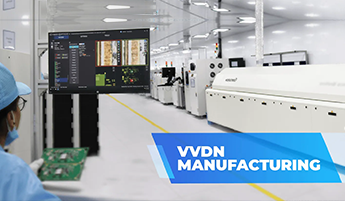
特筆すべきは、VVDN自身が製品として供給するフィジカルAI技術を、自社の製造ラインに直接実装している点です。高密度PCBやデバイスアセンブリセルにリアルタイムAIインスペクション(ビジョンシステム)を導入し、異形部品(Odd-form)の挿入精度補正や実装欠陥の検知に活用しています。
自らフィジカルAIを高度に活用して製品を製造している製造パートナーは、フィジカルAIハードウェアを量産化し、極めて高い信頼性を維持するために必要な実運用レベルのノウハウを熟知しています。これは単なるキャッチフレーズではなく、工場の現場監査(Auditing)によって明確に実証できるアドバンテージです。
フルスクラッチで内製ハードウェアチームを立ち上げるか、実績あるODM/エンジニアリング・パートナーと組むかの選択において、このアプローチは大きな差となります。
最新ヘテロジニアス・シリコンによるエッジAI/ビジョンリファレンス設計の深い知見と、フィジカルAIで高度化された自社生産ラインの組み合わせは、PoC(概念実証)から量産・認証取得済み次世代ロボットへのタイム・ツー・マーケットを劇的に短縮します。
だからこそ、この業界においては単なるシリコンのスペック競争ではなく、システム統合と量産・製造レイヤー(Layer 3)の実行力こそが、真の参入障壁(Competitive Moat)となりつつあるのです。
基盤となるシリコン:アダプティブ・コンピュートのビルディングブロック
前述したシステム・エンジニアリングは、すべてシリコン技術の上に成り立っています。そして過去1年で、フィジカルAI向けコンピュートの選択肢はよりオープンかつ高度に進化しました。
代表例としてAMDが挙げられます。同社のKria AI System-on-Module(SoM)や、”Zen 5″ CPUコア、RDNA 3.5 GPU、および専用NPUを1チップに集積したRyzen AI Embedded X100シリーズ、さらにオープンなROCmベースのソフトウェアスタックは、従来3つの個別チップ(リアルタイム制御MCU、AIアクセラレータ、プロプライエタリSDK)に分断されていた構成を、より少数でオープンなプラットフォームへと統合することを目指しています。
今後の方向性
今後注目すべきトレンドには、以下のようなものがあります。
- VLAモデルのプロダクション・スタックへの本格実装
カメラおよびセンサ入力をモータ制御値へ直接マッピングするVLA(Vision-Language-Action)モデルの台頭は、「ロボティクス向けAI」と「言語/チャット向けAI」のアーキテクチャ的分岐(Divergence)を象徴しています。これにはモデル設計と推論シリコン間の高度なHW/SWコ・デザインが求められます。 - オープンアーキテクチャが要件の必須条件へ
長期的なハードウェア・ロードマップを描くロボティクスOEMは、シリコンおよびSWスタックにおける特定ベンダーへのロックインを明示的に回避し、学習済みポリシーを柔軟に移植(Porting)できるオープンなコンピュート・エコシステムを優先採用しています。 - Sim-to-Realにおける課題の継続
ドメインランダム化(Domain Randomization)、高性能物理エンジン、および合成データ(Synthetic Data)の生成により、シミュレーションと実機動作の乖離は縮小傾向にあります。しかし、これは依然として最大の技術的ボトルネックであり、アルゴリズムの改良だけでなくオンデバイス計算資源の最適化(Compute Budget)と密接に関連しています。 - 製造・システム統合レイヤーが最大の差別化要因に
ロボティクス向けシリコンの選択肢が標準化・オープン化されるにつれ、差別化の軸は「そのコンピュートを、苛烈な実環境に耐えうる製品へと落とし込み、認証を取得し、量産(DFM)できるか」という下流のエンジニアリング力へと完全に移行しています。
フィジカルAIの次のブレークスルーは、単なるモデルの巨大化やシリコン単体の進化だけでは達成されません。ヘテロジニアスなシリコンを、信頼性が高く、各種認証を取得した実運用フリートへと昇華させられるVVDNのようなエンジニアリング・パートナーの存在——フィジカルAIが実際に「形」となる、このミドルレイヤーのエンジニアリングこそが、真の推進力となるのです。